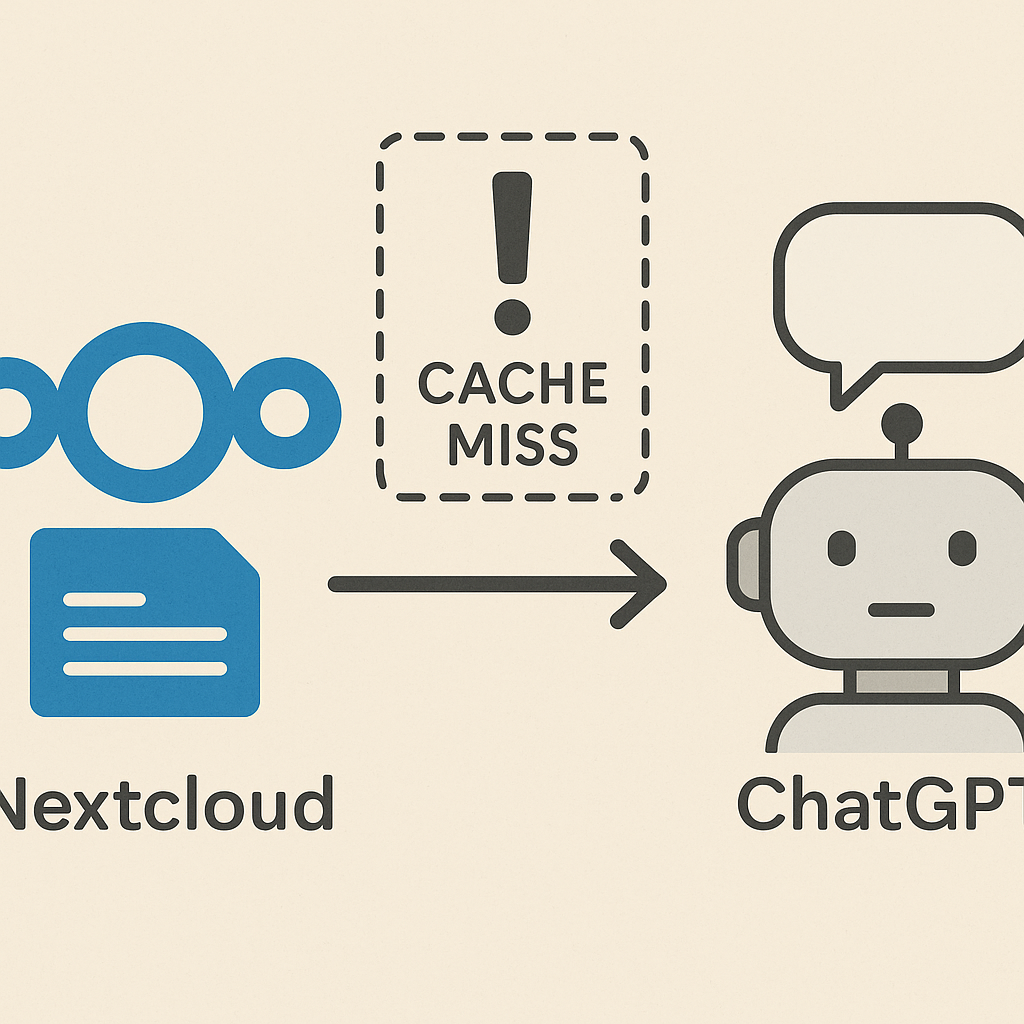
ChatGPTからNextcloud上のファイルを読ませようとしていると、たまに厄介な現象に遭遇します。
Cache miss
しかも不思議なのは、同じURLを普通のブラウザから開くと正常に表示できることです。
Nextcloudも動いている。WordPressのGatewayも正常。サーバーはHTTP 200を返している。巨大CSVのRange取得ならHTTP 206 Partial Contentも返っている。
それなのに、ChatGPTから同じURLを取得するとCache missになる。
しばらくこの問題を追いかけて、Storage BridgeやGateway、Range取得、日時Seekなどいろいろ試しました。
その結果、ひとつ重要なことが分かってきました。
Cache missは、必ずしもNextcloud側のキャッシュ障害ではない。
むしろ今回のケースでは、ChatGPTとNextcloudの間にある「取得経路」を理解したほうが分かりやすいです。
ChatGPTは私のブラウザから直接URLを開いているわけではない
まずここが大前提です。
私がEdgeやChromeでURLを開く場合は、基本的には自分のPCから直接Webサーバーへアクセスします。
↓
Nextcloud / WordPress
一方、ChatGPTがWebページを取得するときは、必ずしも私のブラウザと同じ通信経路を通るわけではありません。
イメージとしては、AI側のWeb取得システムや安全確認、URL処理、キャッシュ、HTTP取得などのレイヤーを通ってから目的のWebサーバーへアクセスします。
↓
URLの解釈・取得処理
↓
AI側のWeb取得レイヤー
↓
Nextcloud / WordPress
つまり、
ブラウザで開けるURL = ChatGPTでも必ず同じように開けるURL
とは限りません。
Cache missとは何なのか
一般的なWebキャッシュでいう「cache miss」は、単純に言えば「そのURLに対応する利用可能なキャッシュが見つからなかった」という意味です。
通常であれば、その後に元のWebサーバーへ取得しに行けば済みます。
ところがAIのWeb取得では、単純なブラウザとは違い、URLの安全確認、リダイレクト、レスポンス形式、ファイルサイズ、認証、取得方式など、いくつもの処理が間に入る可能性があります。
その途中で元データの再取得まで到達できなければ、利用者から見ると「Cache missのまま読めない」という状態になります。
ここで注意したいのは、ChatGPT内部のWeb取得システムの詳細な実装が公開されているわけではないことです。
したがって、ここから先は私が実際に確認した通信結果と、一般的なHTTP・キャッシュ・認証の仕組みを組み合わせて整理したものです。
今回いちばん重要だった「URLが毎回変わる」問題
私が作ったGatewayでは、安全のためURLに署名付きトークンを付けていました。
たとえば概念的には次のようなURLです。
https://example.com/
?gateway=署名付きトークン
&action=range
&path=/ChatGPT-FXdata/USDJPY.csv
&offset=0
&length=4096
トークンには有効期限やnonceなどが含まれるため、新しく発行するたびにURLが変化します。
人間から見れば「同じUSDJPY.csvを読んでいる」だけですが、Webキャッシュから見るとURL文字列が違えば基本的には別のリソースとして扱われます。
USDJPY.csvを読む
キャッシュ側の認識
gateway=ABC123 → URLその1
gateway=XYZ789 → URLその2
gateway=DEF456 → URLその3
内容が同じでも、取得側から見れば毎回「初めて見るURL」になりやすいわけです。
この構造では、過去に取得済みのキャッシュを再利用できる可能性が低くなります。
Cache-Controlも関係する
Private Gatewayでは、古い内容が残ることを避けるため、意図的にキャッシュさせない設定を使うことがあります。
Cache-Control: no-store
Cache-Control: no-cache
private
これはセキュリティや鮮度という意味では正しい設計です。
ただし当然ながら、途中のキャッシュに長期間保存して再利用することも難しくなります。
そのため毎回Origin、つまりWordPressやNextcloudまで取りに行ければ問題ありませんが、その再取得経路で何かにつまずくと、キャッシュにもない、Originからも取得できない、という状態になります。
これがユーザーから見ると非常に分かりにくいところです。
ブラウザでは認証済み、AI側では未認証ということもある
Nextcloudでは認証も重要です。
自分のブラウザではNextcloudへログイン済みで、Cookieやセッション情報を持っています。
しかしAI側のWeb取得システムは、そのブラウザのCookieをそのまま持っているわけではありません。
自分のブラウザ
Cookieあり → Nextcloud認証済み → 読める
別の取得システム
Cookieなし → 未認証 → 読めない場合がある
そのため私は、ChatGPT向けには通常のNextcloudログインセッションではなく、読み取り専用GatewayやWebDAV Bridgeを別に用意していました。
リダイレクトも意外と曲者
Webブラウザはリダイレクトにかなり強いです。
URLを開いたあと301、302、307などで別URLへ移動しても、人間はほとんど意識せず目的のページへ到達できます。
しかし機械的な取得では、リダイレクト先のドメイン、認証情報、Query String、HTTPメソッドなどによって結果が変わることがあります。
Nextcloud、WordPress、WebDAV、CDN、リバースプロキシなどを組み合わせている環境では、実際の通信経路が思っているより複雑になりがちです。
巨大CSVではRange取得も関係してくる
さらに私の環境では、数GBから数十GBのティックCSVを扱っています。
当然、ファイル全体を毎回取得するわけにはいきません。
そこでHTTP Rangeを使います。
Range: bytes=0-4095サーバーが対応していれば、必要な4096バイトだけを返します。
HTTP/1.1 206 Partial Contentこの方法なら、数十GBあるCSVでも必要な場所だけ読むことができます。
しかし一般的なWebページ取得と、巨大ファイルへのRangeアクセスは性質がかなり違います。
そのため、通常のWeb取得レイヤーに任せるより、自作のStorage BridgeでRangeを明示的に制御したほうが安定する場面があります。
サーバー時刻のズレという別の落とし穴もあった
実験中には、さらにややこしい現象もありました。
署名付きURLへ有効期限を入れていたのですが、サーバー側の時刻が実際の時刻とずれていると、新しく発行したURLなのに外から見ると「すでに期限切れ」のように見えることがあります。
署名付きURLでは、URL文字列だけでなく時刻も認証情報の一部です。
そのためGateway方式を使うなら、WordPress、PHP、OS、NTP、署名生成側と検証側の時計も意外と重要です。
実際に起きていたことを整理すると
| 場所 | 状態 |
|---|---|
| Nextcloud | 正常 |
| WordPress Gateway | 正常 |
| ブラウザからアクセス | 正常に表示 |
| Rangeリクエスト | 206 Partial Content |
| 巨大CSV本体 | 正常 |
| ChatGPTの通常Web取得 | Cache missになる場合がある |
| TinyFish経由 | 取得できる |
この状態なら、Nextcloudのファイルが壊れていると考えるより、途中の取得経路の違いを疑うほうが自然です。
なぜTinyFishだとうまくいったのか
そこで現在使っているのがTinyFishです。
TinyFishを使うと、通常のWeb取得とは別のブラウザ操作系の経路でWebサイトへアクセスできます。
私の環境では、これがNextcloudとの相性がかなり良いようです。
↓
TinyFish
↓
Nextcloud
通常のWeb取得でCache missになったURLでも、別の取得経路から実際のWebページへ到達できれば、Nextcloud側のデータを読むことができます。
つまりTinyFishが「キャッシュを修理している」というより、Cache missが発生していた経路そのものを迂回していると考えるほうが分かりやすいです。
だからStorage Bridgeもまだ必要
TinyFishが便利だからといって、Storage Bridgeを捨てるわけではありません。
普通のファイル閲覧ならTinyFishが楽です。
しかし16GBや30GBある巨大CSVの特定部分だけを取得するなら、Rangeや日時Seekを持つStorage Bridgeのほうが圧倒的に効率的です。
TinyFish
Nextcloudを普通に見る・ファイルを探す・内容を確認する
Storage Bridge
巨大CSVをRange取得する・特定日時へSeekする
Work
大量のファイルやデータをまとめて処理する
「Cache missだからサーバーが悪い」とは限らない
今回いちばん学んだのはこれでした。
Cache missという表示だけを見て、NextcloudやWordPressを修正し続けない。
まず普通のブラウザで開けるか確認する。
次にHTTPステータスを見る。
200や206が返っているなら、サーバー本体はかなり正常に近い状態です。
それでもAIから取得できないなら、認証、署名付きURL、Cache-Control、リダイレクト、Query String、Range、そしてAI側の取得経路を切り分けたほうが早いです。
私なりのCache miss発生イメージ
Cache miss
↓
Nextcloudの内容を読める
↓
読めない
実際の内部実装がこの図そのものという意味ではありません。
ただ、今回観測した現象を理解するモデルとしては、かなりしっくり来ています。
結論
ChatGPTからNextcloudを読むときに起きるCache missは、Nextcloudのキャッシュが壊れたという単純な話ではありません。
AIとWebサーバーの間には取得レイヤーがあり、その途中ではURL、キャッシュ、認証、署名、有効期限、HTTP Range、リダイレクトなど複数の要素が関係します。
特に毎回変化する署名付きURLや、キャッシュを残さないPrivate Gatewayは、通常のWebページより取得経路への依存が強くなります。
そして、サーバーが200や206を正常に返しているのにChatGPTだけが取得できないなら、サーバー側だけを直し続けるより、取得経路そのものを変えるという選択肢があります。
私の場合、その答えがTinyFishでした。
Nextcloudが壊れているのではない。
そこへ向かう道の一本が通れなかっただけ。
そう考えるようになってから、Cache missとの付き合い方がかなり楽になりました。